

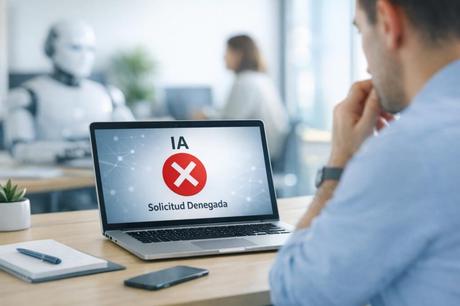
Los límites de los sistemas de IA no son neutrales: son decisiones de diseño tomadas por empresas concretas, con intereses concretos, y aplicadas de forma inconsistente a millones de personas. Cuando ChatGPT de OpenAI, Gemini de Google o Claude de Anthropic se niegan a responder algo, hay capas de lógica detrás de ese «no» que merecen ser examinadas. Algunas están ahí para protegerte. Otras, para proteger a la empresa. Y unas pocas, nadie sabe bien por qué están.
La conversación pública sobre los límites de la IA, la censura de algoritmos y los filtros de contenido suele quedarse en la superficie: o se critica que los modelos son demasiado restrictivos, o se exige que lo sean más. Rara vez se pregunta quién decide dónde poner la línea, con qué criterios, y si esos criterios se aplican igual a todo el mundo.
¿Quién decide lo que una IA puede o no puede decir?
Las empresas de IA deciden los límites de sus modelos a través de un proceso que combina datos de entrenamiento, ajuste fino supervisado y filtros de seguridad añadidos encima del modelo base. No es un proceso transparente ni estandarizado. OpenAI publica documentos de uso aceptable y fichas técnicas de seguridad, pero los detalles concretos de qué instrucciones reciben los modelos, cómo se ponderan los conflictos entre libertad de expresión y daño potencial, y quién tiene la última palabra en esas decisiones no son públicos.
El ajuste fino mediante retroalimentación humana —lo que se conoce como RLHF, Reinforcement Learning from Human Feedback— es una de las herramientas principales. Equipos de trabajadores, generalmente contratados a través de intermediarias, evalúan respuestas del modelo y premian o penalizan comportamientos. Esos trabajadores tienen sus propias perspectivas culturales, sus propios sesgos, y trabajan bajo instrucciones que no siempre son coherentes entre sí. El resultado es un modelo que en algunos casos rechaza hablar de violencia en un contexto educativo, pero en otros describe esa misma violencia con detalle si se enmarca como ficción.
Meta, por ejemplo, publica los pesos de sus modelos Llama, lo que permite a investigadores examinar parte de su funcionamiento. OpenAI y Anthropic no lo hacen, alegando riesgos de seguridad. Esa diferencia de apertura tiene consecuencias directas sobre la posibilidad de auditar los límites que estos sistemas aplican a sus usuarios.
¿Los filtros de contenido protegen o controlan?
Los filtros de contenido de los grandes modelos de lenguaje hacen las dos cosas, y es imposible separar ambas funciones con limpieza. El sistema que impide que un chatbot explique cómo fabricar un explosivo es el mismo sistema —o un sistema muy parecido— que en algunos casos bloquea información sobre salud reproductiva, que trata el término «Hamas» de forma diferente según el contexto geopolítico del usuario, o que se niega a escribir chistes sobre ciertas religiones pero no sobre otras.
Los límites de la IA en materia de censura de algoritmos no se aplican de forma simétrica. Esto está documentado. Investigaciones publicadas por organizaciones como el Algorithmic Justice League y estudios académicos independientes han señalado patrones de inconsistencia: los modelos son más restrictivos con contenido relacionado con ciertos grupos políticos, ciertas culturas o ciertos temas tabú dependiendo de la región o el idioma. Un mismo prompt en inglés y en español puede recibir respuestas radicalmente distintas, no porque las reglas cambien, sino porque el entrenamiento en distintos idiomas ha sido desigual.
Hay un caso que ilustra bien la tensión. En 2023, varios usuarios descubrieron que GPT-4 rechazaba escribir poesía elogiando a figuras políticas conservadoras mientras hacía lo propio con figuras progresistas. OpenAI reconoció el problema y lo ajustó, pero el episodio reveló algo estructural: los modelos heredan inclinaciones de sus datos de entrenamiento que los propios creadores no siempre detectan hasta que alguien las señala públicamente. Como ya vimos al explorar cómo funcionan realmente estas arquitecturas, la red no sabe lo que sabe ni lo que no sabe.
Esto conecta con una pregunta más incómoda: ¿a quién sirve un filtro que nadie puede auditar? Si una empresa puede modificar los límites de su modelo sin explicación pública, también puede usar esos mismos mecanismos para suavizar críticas a sus socios comerciales, endurecer el tratamiento de ciertos temas que afecten a sus intereses o simplemente evitar problemas legales en mercados específicos.
¿Qué pasa cuando los límites son demasiado laxos o demasiado rígidos?
Ambos extremos generan daño real, aunque de tipos distintos. Un modelo sin límites suficientes puede producir instrucciones detalladas para actividades peligrosas, generar deepfakes sin consentimiento o ser usado para acosar personas concretas de forma automatizada. Un modelo excesivamente restrictivo puede impedir que una enfermera obtenga información sobre interacciones farmacológicas, que un periodista investigue extremismo o que un estudiante acceda a material histórico sobre atrocidades.
El problema es que los límites de la IA no escalan igual para todos los usuarios. Las versiones de pago suelen ser menos restrictivas que las gratuitas. Las APIs para desarrolladores permiten más que las interfaces de consumo. Algunos sectores —salud, defensa, investigación académica— negocian accesos especiales con las empresas. El resultado es un sistema donde el nivel de censura de algoritmos que experimentas depende, en parte, de cuánto pagas y de quién eres.
Anthropic ha publicado documentación sobre su modelo de «escalado de seguridad», que intenta ajustar los límites según el nivel de riesgo del caso de uso. Es uno de los enfoques más detallados que hay públicamente, aunque sigue siendo la empresa quien define qué constituye riesgo y qué no. La IA no miente intencionadamente, pero sus filtros sí pueden silenciar información verdadera sin ningún aviso al usuario.
Hay también un fenómeno bien documentado llamado «jailbreaking»: el proceso por el que usuarios encuentran formas de circunvalar los límites del modelo mediante prompts elaborados. Que exista una comunidad activa dedicada a esto dice algo sobre la percepción de esos límites como barreras arbitrarias. Cuando los usuarios necesitan trucos para hacer preguntas legítimas, algo en el diseño del sistema ha fallado.
¿Existen límites que ninguna empresa decide conscientemente?
Sí, y son quizás los más difíciles de abordar. Junto a los límites deliberados —los que una empresa programa, revisa y ajusta— existen límites emergentes que nadie diseñó explícitamente. Son el resultado de sesgos en los datos de entrenamiento, de decisiones técnicas que nadie tomó pensando en su efecto final, de interacciones entre partes del sistema que no fueron previstas.
Un modelo entrenado principalmente con texto en inglés procedente de internet tendrá puntos ciegos sobre culturas, idiomas y realidades sociales que están subrepresentadas en esa fuente. No es una decisión de censura: es una consecuencia de qué datos existían, eran accesibles y se usaron. Pero el efecto para el usuario es el mismo: ciertos conocimientos, perspectivas y formas de ver el mundo quedan fuera del alcance del modelo, sin que nadie lo haya decidido conscientemente.
Esto enlaza con debates más amplios sobre quién tiene acceso a Internet, quién produce contenido en qué idiomas y qué voces son sistemáticamente menos representadas en el archivo digital de la humanidad. El capitalismo de vigilancia lleva décadas amplificando unas voces y silenciando otras; los modelos de lenguaje no empiezan desde cero, empiezan desde ese archivo sesgado.
Los límites emergentes también aparecen en forma de «alucinaciones» que el modelo no reconoce como tales, de temas sobre los que el modelo expresa confianza injustificada, o de áreas donde el modelo es sistemáticamente más cauto de lo necesario porque sus datos de entrenamiento contenían más ejemplos de daño que de uso legítimo. Lo que nadie cuenta sobre los modelos de lenguaje es precisamente esto: que muchos de sus comportamientos no fueron diseñados, simplemente emergieron.
¿Hay regulación sobre los límites de la IA?
La regulación de los límites de la IA está en sus etapas más tempranas, pero avanza. El Reglamento de IA de la Unión Europea, que entró en vigor en 2024, clasifica los sistemas de IA por nivel de riesgo e impone obligaciones de transparencia y supervisión humana para los de alto riesgo. Sin embargo, la normativa no especifica qué límites deben tener los modelos de uso general: eso sigue siendo territorio de las empresas.
En Estados Unidos, la situación es más fragmentada. La Executive Order sobre IA firmada por Biden en 2023 estableció directrices para agencias federales, pero sin fuerza vinculante para las empresas privadas. Con el cambio de administración en 2025, parte de ese marco ha sido revisado o derogado. El vacío regulatorio favorece a quien tiene más recursos para establecer sus propios estándares, que en este caso son las mismas empresas cuyos modelos están siendo evaluados.
China, en contraste, tiene regulaciones específicas sobre IA generativa que obligan a los modelos a alinearse con «los valores socialistas fundamentales». Es un ejemplo extremo de cómo un gobierno puede formalizar lo que las empresas occidentales hacen de forma implícita: decidir qué puede y no puede decir un modelo. La diferencia no es tanto de tipo como de grado y de quién ostenta el poder de decisión.
La propuesta más interesante que circula entre investigadores es la de auditorías independientes obligatorias de los sistemas de moderación, similares a las auditorías financieras. Organizaciones como el AI Safety Institute del Reino Unido están trabajando en marcos para hacer esto posible, aunque todavía sin capacidad coercitiva real. Cuando los algoritmos toman decisiones sobre personas, la falta de auditoría no es solo un problema técnico: es un problema democrático.
Mientras tanto, los usuarios de a pie no tienen acceso a las instrucciones de sistema que configuran los modelos que usan, no saben con exactitud qué filtra un modelo y por qué, y no tienen mecanismos reales de recurso cuando un límite les parece injustificado. La IA toma decisiones que el usuario no entiende y, en este caso, tampoco puede cuestionar con información real.
¿Quién debería decidir lo que la IA puede decir, y cómo lo decidimos nosotros?
La pregunta de fondo en el debate sobre los límites de la IA, la censura de algoritmos y los filtros de contenido no es técnica: es política. Decidir qué puede decir un sistema que usan cientos de millones de personas es, en la práctica, decidir qué información fluye y cuál no, qué perspectivas se normalizan y cuáles se marginan, qué preguntas son legítimas y cuáles no. Eso es exactamente lo que hacen las instituciones de poder. Y lo están haciendo empresas privadas sin mandato democrático, sin transparencia suficiente y con incentivos que no siempre coinciden con el interés público.
No hay una respuesta limpia. Un modelo sin límites es un problema real. Un modelo con límites opacos e inconsistentes también lo es. El debate que nos falta no es si debe haber límites, sino quién los fija, con qué proceso, con qué supervisión y con qué posibilidad real de cuestionarlos. Mientras esa conversación no sea pública y vinculante, los límites de la IA seguirán siendo, sobre todo, los límites de quien tiene el dinero y el poder para programarlos.
La siguiente vez que un modelo te diga que no, vale la pena preguntarse: ¿no puede, o no le han permitido?
Preguntas frecuentes
¿Por qué los modelos de IA como ChatGPT o Gemini a veces rechazan preguntas inofensivas?
Los filtros de contenido no son quirúrgicos: están diseñados para bloquear categorías amplias de contenido potencialmente peligroso y, como consecuencia, también bloquean preguntas legítimas que se parecen superficialmente a esas categorías. Es un error de calibración, no una decisión consciente sobre tu pregunta concreta. Las empresas ajustan estos filtros continuamente, aunque los criterios exactos no son públicos.
¿Puedo saber exactamente qué instrucciones tiene el modelo que uso?
En la mayoría de casos, no. Las instrucciones de sistema que configuran el comportamiento de modelos como GPT-4 o Claude son confidenciales. Algunas empresas publican documentos generales de política de uso aceptable, pero los detalles técnicos de qué está bloqueado y por qué no están disponibles para el usuario final. Es uno de los problemas de transparencia más señalados por investigadores de IA.
¿Los filtros de IA se aplican igual en todos los idiomas?
No. Hay evidencia documentada de que los modelos de lenguaje se comportan de forma diferente según el idioma, porque el entrenamiento en distintas lenguas ha sido desigual en cantidad y calidad. Un mismo prompt en inglés y en español puede producir respuestas distintas. Esto no es una política deliberada, sino una consecuencia de cómo se construyeron los modelos, aunque el efecto para el usuario es el mismo.
¿Hay alguna forma de que los usuarios cuestionen un límite que consideran injusto?
En la práctica, las opciones son muy limitadas. La mayoría de plataformas ofrecen formularios de feedback o mecanismos para reportar errores, pero no hay un proceso formal de recurso que garantice revisión ni respuesta. Los cambios en los filtros suelen producirse cuando el problema se hace visible públicamente o cuando afecta a suficientes usuarios como para generar presión mediática.
¿La regulación europea obliga a las empresas de IA a ser más transparentes sobre sus filtros?
El Reglamento de IA de la UE exige transparencia y supervisión humana para sistemas de alto riesgo, pero no establece reglas específicas sobre qué deben o no deben filtrar los modelos de uso general como los chatbots. Las empresas siguen teniendo amplia discreción sobre dónde ponen los límites. La normativa europea es el marco más avanzado que existe, pero deja sin resolver buena parte de las preguntas sobre quién decide qué puede decir la IA.
¿Es lo mismo un límite de seguridad que una censura?
Depende de quién define «seguridad» y con qué criterios. Un límite que impide instrucciones para fabricar armas biológicas es difícilmente cuestionable. Un límite que bloquea información histórica sobre conflictos armados porque contiene términos asociados a violencia es más discutible. El problema es que ambos tipos conviven en los mismos sistemas, aplicados de forma inconsistente y sin mecanismos claros para distinguirlos.




 Puzzle Bobble
 Karate Blazers
 Puzzle De Bloques
 Magical Cat Adventure