

Los modelos de inteligencia artificial pueden responder preguntas sobre una enorme cantidad de temas, pero existe un problema fundamental: no conocen automáticamente tus documentos privados, la información interna de una empresa ni todo aquello que ocurrió después de los datos con los que fueron entrenados.
Una forma de solucionar parte de este problema consiste en proporcionar al modelo información relevante justo cuando necesita responder.
Ese es el principio detrás de RAG, siglas de Retrieval-Augmented Generation.
En español suele traducirse como generación aumentada por recuperación.
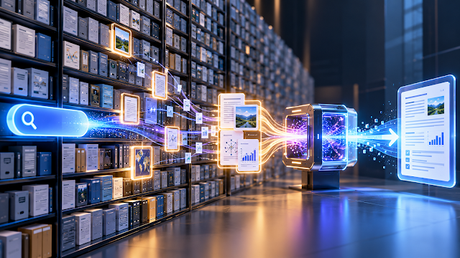
RAG permite que un sistema busque información relacionada con la pregunta del usuario dentro de una fuente de conocimiento y proporcione los fragmentos relevantes al modelo antes de generar la respuesta.
En lugar de esperar que la IA recuerde internamente todos los datos necesarios, el sistema puede buscar primero y responder después.
En esta guía de TuParadaDigital explicaremos cómo funciona RAG, qué son los embeddings y las bases vectoriales, cuáles son sus ventajas y limitaciones y en qué se diferencia de tecnologías como MCP, búsqueda web, memoria y entrenamiento del modelo.
¿Qué significa RAG?
RAG significa Retrieval-Augmented Generation.
El concepto combina dos operaciones:
- Retrieval: recuperar información relevante.
- Generation: utilizar un modelo generativo para producir la respuesta.
En un sistema RAG, la IA no responde necesariamente utilizando únicamente el conocimiento incorporado durante su entrenamiento.
Antes de generar la respuesta, el sistema puede buscar información relevante en una colección de documentos y añadirla al contexto disponible para el modelo.
Microsoft resume este objetivo como generar respuestas fundamentadas en documentos relevantes recuperados a partir de la consulta del usuario. OpenAI también describe RAG como la técnica de añadir contexto relevante recuperado antes de la generación.
Un ejemplo sencillo para entender RAG
Imagina una empresa con 20.000 páginas de documentación interna.
Un empleado pregunta:
“¿Cuál es nuestra política actual para solicitar vacaciones?”
El modelo de IA utilizado por la empresa no tiene por qué conocer esa política.
Con RAG, el sistema puede realizar aproximadamente este proceso:
- recibe la pregunta;
- busca en la documentación interna;
- encuentra los fragmentos relacionados con vacaciones;
- selecciona los más relevantes;
- los proporciona al modelo junto con la pregunta;
- el modelo genera una respuesta utilizando esa información.
Así, el modelo puede responder basándose en documentación específica que no necesariamente formaba parte de sus datos de entrenamiento.
RAG no cambia permanentemente el modelo
Esta es una de las diferencias más importantes.
Cuando utilizamos RAG, normalmente no estamos reentrenando el modelo.
La información recuperada se incorpora al contexto de la solicitud actual.
Podemos imaginarlo como entregar a una persona varios documentos relevantes justo antes de pedirle que responda una pregunta.
La persona no ha memorizado permanentemente todos los documentos. Simplemente dispone de la información necesaria mientras prepara la respuesta.
RAG utiliza una lógica parecida.
¿Cómo funciona RAG paso a paso?
Una implementación puede variar considerablemente, pero el flujo clásico suele dividirse en dos grandes fases: preparación y consulta.
Fase 1: preparar el conocimiento
Antes de poder recuperar información, el sistema necesita preparar los documentos.
1. Recopilar las fuentes
El conocimiento puede proceder de:
- manuales;
- documentación;
- PDF;
- páginas internas;
- bases de conocimiento;
- informes;
- artículos;
- datos estructurados;
- otros repositorios autorizados.
2. Dividir los documentos
Los documentos grandes suelen dividirse en fragmentos más pequeños conocidos como chunks.
Esto permite recuperar solamente las partes potencialmente relevantes para una pregunta en lugar de enviar toda la biblioteca al modelo.
OpenAI, por ejemplo, documenta que los archivos añadidos a sus vector stores son fragmentados, convertidos en embeddings e indexados automáticamente. :chatgpt-content-reference{index="1"}
3. Representar el significado
Muchos sistemas utilizan embeddings.
Un embedding es una representación numérica que intenta capturar características semánticas del contenido.
Esto permite comparar la proximidad conceptual entre una pregunta y diferentes fragmentos de documentos.
Por ejemplo, una consulta sobre “cómo solicitar días libres” puede recuperar un fragmento titulado “procedimiento para vacaciones” aunque no utilice exactamente las mismas palabras.
4. Crear un índice consultable
Las representaciones se almacenan en un sistema preparado para realizar búsquedas eficientes.
Una opción habitual es utilizar una base o índice vectorial.
OpenAI utiliza vector stores para su Retrieval API y file search. Estos funcionan como índices sobre los datos disponibles para búsqueda semántica. :chatgpt-content-reference{index="2"}
Fase 2: responder una pregunta
Cuando el conocimiento ya está preparado, comienza el flujo de consulta.
1. El usuario hace una pregunta
Por ejemplo:
“¿Cuántos días tengo para devolver un producto?”
2. El sistema busca información relacionada
La consulta se utiliza para encontrar los fragmentos más relevantes.
La búsqueda puede utilizar similitud semántica, palabras clave, filtros de metadatos o una combinación de diferentes técnicas.
3. Se selecciona el contexto
No todos los resultados recuperados tienen que proporcionarse al modelo.
El sistema puede seleccionar y ordenar los fragmentos más útiles.
4. El modelo recibe pregunta + contexto
Conceptualmente, la solicitud puede convertirse en algo parecido a:
Pregunta: ¿Cuántos días tengo para devolver un producto?
Contexto recuperado: fragmentos relevantes de la política de devoluciones.
Instrucción: responde utilizando la información proporcionada.
5. La IA genera la respuesta
El modelo utiliza el contexto recuperado para preparar una respuesta fundamentada en esas fuentes.
Ese ciclo de buscar → recuperar → proporcionar contexto → generar resume la idea esencial de RAG.
¿Qué es una búsqueda semántica?
La búsqueda tradicional suele depender fuertemente de coincidencias entre palabras.
La búsqueda semántica intenta recuperar información según su significado.
OpenAI proporciona un ejemplo ilustrativo: una búsqueda relacionada con el momento en que el ser humano llegó a la Luna puede recuperar correctamente un fragmento sobre el primer alunizaje aunque las palabras exactas de la consulta no aparezcan en el texto recuperado. :chatgpt-content-reference{index="3"}
Esto resulta especialmente útil porque las personas pueden expresar el mismo concepto de muchas maneras diferentes.
¿Qué es una base de datos vectorial?
Una base vectorial es un sistema optimizado para almacenar y buscar representaciones vectoriales.
En RAG puede utilizarse para encontrar fragmentos semánticamente próximos a una consulta.
Pero conviene evitar una simplificación frecuente:
RAG no significa obligatoriamente “usar una base vectorial”.
La recuperación puede combinar diferentes técnicas.
Anthropic, por ejemplo, describe sistemas que combinan embeddings con BM25, una técnica de recuperación basada en coincidencias léxicas, para aprovechar tanto similitud semántica como coincidencias exactas. :chatgpt-content-reference{index="4"}
¿Qué es la búsqueda híbrida?
Una búsqueda puramente semántica puede comprender conceptos relacionados, pero a veces una coincidencia exacta es extremadamente importante.
Piensa en:
- un código de producto;
- un número de factura;
- una sigla específica;
- un nombre propio;
- una referencia técnica.
La búsqueda híbrida intenta combinar las ventajas de diferentes métodos.
Puede utilizar búsqueda semántica para comprender el significado y búsqueda léxica para detectar coincidencias precisas.
Después, un sistema de ranking puede decidir qué resultados deberían utilizarse.
¿Qué es reranking?
Recuperar documentos candidatos es solamente una parte del problema.
También hay que decidir cuáles son realmente los mejores.
El reranking consiste en volver a evaluar y ordenar resultados recuperados para priorizar aquellos que parecen más relevantes para la consulta.
Esto puede mejorar considerablemente la calidad del contexto que finalmente recibe el modelo.
La investigación de Anthropic sobre Contextual Retrieval mostró precisamente mejoras importantes al combinar recuperación contextual y reranking en sus pruebas. :chatgpt-content-reference{index="5"}
¿Por qué dividir documentos puede causar problemas?
Los chunks facilitan la búsqueda, pero también pueden eliminar contexto.
Imagina un fragmento que diga:
“Los ingresos aumentaron un 3 % respecto al trimestre anterior.”
Aislado, ese fragmento puede no indicar de qué empresa, año o trimestre está hablando.
Anthropic utiliza precisamente este tipo de problema para explicar una limitación de los sistemas RAG tradicionales: al fragmentar documentos, parte del contexto necesario para recuperar correctamente un pasaje puede desaparecer. :chatgpt-content-reference{index="6"}
Por eso existen técnicas destinadas a enriquecer los chunks con contexto adicional antes de indexarlos.
¿Qué es Contextual Retrieval?
Anthropic propuso Contextual Retrieval como una forma de mejorar la recuperación añadiendo contexto específico a cada fragmento antes de generar sus representaciones de búsqueda.
La idea consiste en ayudar al sistema a comprender a qué documento, sección o situación pertenece un fragmento.
No significa que todos los sistemas RAG necesiten implementar exactamente esa técnica. Es un ejemplo de cómo la calidad del retrieval puede mejorarse más allá de simplemente dividir documentos y crear embeddings.
¿Por qué RAG puede mejorar una respuesta?
RAG ofrece varias ventajas importantes.
Acceso a conocimiento privado
Puede permitir que un modelo responda utilizando documentación que no estaba incluida en su entrenamiento.
Información actualizable
Una base de conocimiento puede modificarse sin tener que volver a entrenar completamente el modelo.
Respuestas fundamentadas
El sistema puede proporcionar al modelo documentos concretos relacionados con la pregunta.
Grandes colecciones documentales
En lugar de introducir toda una biblioteca dentro de cada prompt, puede recuperar solamente una parte relevante.
Trazabilidad
Cuando la implementación conserva la procedencia de los fragmentos, puede ser posible mostrar qué documentos sustentan una respuesta.
RAG no garantiza que una respuesta sea correcta
Esta advertencia es fundamental.
RAG puede proporcionar mejores fuentes al modelo, pero todavía pueden ocurrir errores.
El sistema puede:
- recuperar el documento equivocado;
- no encontrar el documento correcto;
- seleccionar fragmentos incompletos;
- interpretar incorrectamente el contexto;
- generar una conclusión que las fuentes no respaldan;
- utilizar información obsoleta presente en la base.
Por eso, Microsoft distingue entre evaluar la calidad de la recuperación y evaluar la calidad de la respuesta final en sistemas RAG. :chatgpt-content-reference{index="7"}
Un sistema puede tener un modelo excelente y una recuperación deficiente, o recuperar buenos documentos y generar una respuesta incorrecta.
La calidad de RAG depende de la fuente
Si la base de conocimiento contiene información incorrecta, contradictoria o desactualizada, recuperar esa información no soluciona el problema.
RAG no convierte una fuente mala en una fuente fiable.
Esto significa que la gestión del conocimiento sigue siendo importante:
- seleccionar fuentes confiables;
- eliminar duplicados innecesarios;
- actualizar documentación;
- conservar metadatos;
- identificar versiones;
- gestionar permisos;
- retirar información obsoleta.
RAG vs. entrenamiento del modelo
RAG y entrenamiento resuelven problemas diferentes.
Recupera información durante la consulta Modifica parámetros o comportamiento del modelo mediante un proceso de entrenamiento
La base puede actualizarse independientemente Los cambios requieren un nuevo proceso de entrenamiento o ajuste
Útil para conocimiento documental cambiante Útil para otros objetivos, como adaptar comportamientos o tareas específicas
Puede conservar referencias a fuentes recuperadas El conocimiento aprendido no funciona como una biblioteca documental consultable
No son enfoques mutuamente excluyentes. Un sistema puede utilizar un modelo ajustado y además incorporar RAG.
RAG vs. contexto largo
Los modelos actuales pueden procesar cantidades de contexto cada vez mayores.
Entonces, ¿por qué no proporcionar todos los documentos directamente?
En algunos casos esa puede ser precisamente la mejor solución.
Anthropic señala que, cuando una base de conocimiento cabe razonablemente dentro del contexto disponible, incluirla directamente puede ser más sencillo que construir un sistema RAG completo. :chatgpt-content-reference{index="8"}
RAG adquiere especial utilidad cuando la colección crece y resulta ineficiente o imposible incluir todo en cada solicitud.
Por tanto, RAG no debería utilizarse automáticamente simplemente porque existe.
RAG vs. búsqueda web
Ambas técnicas recuperan información, pero la fuente y el propósito pueden ser diferentes.
Una búsqueda web consulta información disponible en Internet.
Un sistema RAG puede consultar una colección controlada de documentos, aunque técnicamente una arquitectura de recuperación también puede incorporar información procedente de búsquedas externas.
Para una empresa, por ejemplo, RAG puede utilizar manuales privados que nunca aparecen en la web.
Para investigar una noticia reciente, la búsqueda web puede ser más apropiada.
Algunos sistemas combinan ambos enfoques.
RAG vs. memoria de una IA
La memoria suele referirse a mecanismos mediante los que una aplicación conserva determinada información entre interacciones o sobre el usuario.
RAG se centra en recuperar información relevante desde una colección de conocimiento para responder una consulta.
Conceptualmente son funciones diferentes, aunque una aplicación puede combinarlas.
Una memoria podría conservar una preferencia del usuario. Un sistema RAG podría recuperar cinco páginas de documentación relacionadas con la pregunta actual.
RAG vs. MCP
Esta diferencia es especialmente importante después de nuestra guía anterior.
RAG responde principalmente a la pregunta:
“¿Qué información relevante debería recuperar para ayudar al modelo a responder?”
MCP responde principalmente a otra:
“¿Cómo puede una aplicación de IA conectarse de manera estandarizada con herramientas y fuentes externas?”
MCP es un protocolo de conexión. RAG es una arquitectura o técnica de recuperación y generación.
Pueden trabajar juntos.
Por ejemplo, un agente podría acceder mediante MCP a una herramienta de búsqueda documental que internamente utiliza RAG.
Si quieres profundizar en esta diferencia, consulta nuestra guía sobre qué es MCP y cómo conecta las IA con herramientas.
RAG y los agentes de IA
Un agente puede necesitar consultar información antes de decidir qué hacer.
RAG puede proporcionar una capa de conocimiento recuperable para ese agente.
Por ejemplo, un agente de soporte podría:
- recibir la pregunta de un cliente;
- buscar información relevante en la documentación mediante retrieval;
- generar una respuesta basada en las fuentes;
- consultar otra herramienta si necesita datos específicos del cliente;
- solicitar intervención humana si el caso supera sus permisos.
En este escenario, RAG es una parte del sistema, no el sistema completo.
Puedes revisar nuestra guía sobre qué son los agentes de IA para comprender el resto de componentes.
RAG y los prompts
La información recuperada termina formando parte del contexto que utiliza el modelo.
Por eso retrieval y prompting están relacionados.
Una aplicación puede indicarle al modelo:
“Responde utilizando únicamente los fragmentos proporcionados. Si las fuentes no contienen la respuesta, indícalo.”
Pero una instrucción de ese tipo no garantiza por sí sola que el comportamiento sea perfecto.
También hay que evaluar qué información se recuperó y cómo la utiliza el modelo.
Para mejorar tus instrucciones, consulta nuestra guía sobre cómo crear buenos prompts para ChatGPT, Claude y otras IA.
RAG en ChatGPT y herramientas de OpenAI
OpenAI proporciona actualmente herramientas de retrieval y file search para desarrolladores.
Los archivos pueden almacenarse en vector stores y utilizarse para búsquedas semánticas.
File search permite que el modelo busque información relevante en archivos previamente cargados antes de generar una respuesta. Además de búsqueda semántica, la herramienta puede utilizar búsqueda por palabras clave. :chatgpt-content-reference{index="9"}
Esto representa una implementación práctica del principio de aumentar la generación con información recuperada.
RAG en Claude
Anthropic también utiliza RAG en experiencias con grandes colecciones documentales.
En Claude Projects, cuando el conocimiento del proyecto se aproxima o supera determinados límites de contexto, Claude puede utilizar recuperación para buscar la información relevante en los documentos en lugar de cargar todo el contenido simultáneamente. :chatgpt-content-reference{index="10"}
Es un ejemplo útil porque demuestra que RAG puede funcionar de manera prácticamente invisible para el usuario.
No siempre necesitas construir personalmente una base vectorial para beneficiarte de retrieval.
¿Necesitas saber programar para utilizar RAG?
No necesariamente.
Muchas aplicaciones implementan sistemas de recuperación detrás de su interfaz.
Un usuario puede cargar documentos, hacer preguntas y beneficiarse de retrieval sin configurar embeddings ni bases vectoriales manualmente.
Sin embargo, construir una arquitectura RAG personalizada sí puede requerir conocimientos sobre:
- procesamiento de documentos;
- chunking;
- embeddings;
- búsqueda;
- bases vectoriales;
- ranking;
- modelos generativos;
- evaluación;
- seguridad;
- infraestructura.
Casos de uso de RAG
Soporte al cliente
Recuperar políticas, manuales y documentación antes de responder preguntas.
Documentación empresarial
Consultar grandes repositorios internos mediante lenguaje natural.
Investigación
Buscar pasajes relevantes dentro de colecciones de informes, estudios o documentos.
Asistentes especializados
Construir sistemas que respondan utilizando una base documental específica.
Educación
Consultar materiales de estudio y generar explicaciones basadas en los documentos proporcionados.
Productos y servicios
Responder preguntas utilizando catálogos, manuales, especificaciones y documentación actualizada.
Riesgos y limitaciones de RAG
Recuperación incorrecta
Si el sistema recupera información irrelevante, el modelo comienza con un contexto deficiente.
Información obsoleta
Una base de conocimiento desactualizada puede producir respuestas desactualizadas.
Pérdida de contexto
Fragmentar documentos puede separar información que debería interpretarse conjuntamente.
Permisos
Un sistema no debería recuperar documentos que el usuario no esté autorizado a consultar.
Prompt injection
Los documentos recuperados pueden contener instrucciones maliciosas o contenido diseñado para manipular al modelo, especialmente cuando RAG forma parte de sistemas agentic con herramientas.
Falsa sensación de certeza
Que una respuesta utilice documentos no significa automáticamente que interprete correctamente esos documentos.
Cómo evaluar un sistema RAG
No basta con preguntar si “la respuesta parece buena”.
Conviene evaluar al menos dos etapas.
1. Calidad de recuperación
¿El sistema encontró los documentos que realmente contenían la respuesta?
2. Calidad de generación
¿La respuesta representa correctamente lo que dicen los documentos recuperados?
Microsoft documenta evaluadores específicos para medir el proceso de retrieval y la calidad de respuestas fundamentadas en sistemas RAG. :chatgpt-content-reference{index="11"}
Esta separación ayuda a diagnosticar errores.
Si el documento correcto nunca fue recuperado, cambiar solamente el prompt del modelo puede no solucionar el problema.
Cuándo tiene sentido utilizar RAG
RAG puede ser especialmente apropiado cuando:
- tienes una colección documental demasiado grande para introducirla completa;
- el conocimiento cambia con frecuencia;
- necesitas utilizar información privada;
- quieres fundamentar respuestas en documentos específicos;
- necesitas recuperar solamente información relevante para cada consulta.
Cuándo puede no ser necesario
No todos los proyectos necesitan RAG.
Puede ser innecesario cuando:
- la información relevante cabe fácilmente en el contexto;
- la tarea no necesita conocimiento externo;
- una consulta directa a una base de datos es suficiente;
- una búsqueda tradicional resuelve mejor el problema;
- la complejidad de mantener retrieval supera el beneficio.
La arquitectura más sofisticada no siempre es la mejor.
De los modelos que “saben” a los sistemas que buscan
RAG representa un cambio conceptual importante.
Durante mucho tiempo evaluábamos una IA principalmente por lo que parecía saber internamente.
Ahora podemos construir sistemas donde el modelo utiliza diferentes capas:
- conocimiento aprendido durante entrenamiento;
- contexto proporcionado por el usuario;
- documentos recuperados;
- búsqueda web;
- herramientas externas;
- memoria;
- agentes y automatizaciones.
Eso significa que el futuro de una aplicación de IA no depende únicamente de qué modelo utiliza.
También depende de qué información puede recuperar, qué fuentes consulta y cómo verifica y utiliza ese contexto.
RAG y la investigación con inteligencia artificial
Comprender retrieval también ayuda a utilizar mejor herramientas de investigación.
Cuando una IA puede buscar información actual, consultar documentos y proporcionar fuentes, el usuario debería prestar atención no solamente a la respuesta final, sino también a qué información fue recuperada y de dónde procede.
En nuestra próxima guía veremos de forma práctica cómo usar ChatGPT para investigar mejor, trabajar con fuentes y verificar información.
Conclusión
RAG, o Retrieval-Augmented Generation, permite mejorar una aplicación de inteligencia artificial recuperando información relevante antes de generar una respuesta.
En lugar de depender exclusivamente de lo que el modelo aprendió durante su entrenamiento, el sistema puede buscar documentos relacionados con la pregunta y proporcionarlos como contexto.
Esto hace posible trabajar con grandes bases documentales, información privada y conocimiento que puede actualizarse independientemente del modelo.
Pero RAG no elimina los errores.
Una buena implementación necesita recuperar los documentos correctos, conservar suficiente contexto, utilizar fuentes fiables, respetar permisos y comprobar que la respuesta realmente está respaldada por la información recuperada.
Tampoco debemos confundirlo con MCP, memoria, búsqueda web o entrenamiento.
Cada tecnología resuelve una parte diferente del problema.
La idea esencial de RAG puede resumirse de manera sencilla:
cuando la IA no debería depender solamente de lo que recuerda, primero recupera la información relevante y después responde.
Preguntas frecuentes sobre RAG
¿Qué significa RAG en inteligencia artificial?
RAG significa Retrieval-Augmented Generation o generación aumentada por recuperación. Es una técnica que recupera información relevante y la proporciona al modelo como contexto antes de generar una respuesta.
¿RAG entrena al modelo con mis documentos?
No necesariamente. En una arquitectura RAG típica, los documentos se recuperan durante la consulta y se proporcionan como contexto. Esto es diferente de modificar los parámetros del modelo mediante entrenamiento.
¿RAG necesita una base vectorial?
Las bases vectoriales son muy habituales, pero RAG puede utilizar o combinar diferentes técnicas de recuperación, incluyendo búsqueda semántica, palabras clave y sistemas híbridos.
¿RAG elimina las alucinaciones?
No. Puede mejorar el fundamento de las respuestas proporcionando información relevante, pero el retrieval y la generación todavía pueden cometer errores.
¿Cuál es la diferencia entre RAG y MCP?
RAG es una técnica para recuperar información y utilizarla durante la generación. MCP es un protocolo para conectar aplicaciones de IA con herramientas y fuentes externas. Ambos pueden utilizarse juntos.
¿RAG es lo mismo que búsqueda web?
No. La búsqueda web recupera información de Internet. RAG puede utilizar una colección privada o controlada de documentos, aunque una arquitectura de recuperación también puede incorporar fuentes web.
¿ChatGPT puede utilizar RAG?
Los productos y APIs de OpenAI disponen de capacidades de búsqueda sobre archivos y retrieval que permiten implementar este tipo de arquitectura. Las capacidades concretas dependen del producto y configuración.
¿Para qué sirve RAG?
Es especialmente útil para asistentes sobre documentación, soporte, investigación, bases de conocimiento empresariales y aplicaciones que necesitan respuestas basadas en información específica o actualizable.


Revistas
LA COMUNIDAD INFORMÁTICA
-
 Cristina Sanjosé
3904155 pt -
cupcakeshermosos
2434711 pt -
 saludyenergia
2137758 pt -
 husmeandoporlared
2098750 pt
JUEGOS EN ES.PAPERBLOG.COM
-
 Puzzle Bobble
Un clásico juego de Arcade. ...... Juega -
 Karate Blazers
 es un juego de Arcade, que forma...... Juega -
 Puzzle De Bloques
Inventado en 1984 por el ruso Alekséi Pázhitnov, e...... Juega -
 Magical Cat Adventure
Redescubre Magical Cat Adventure, un juego de la...... Juega